
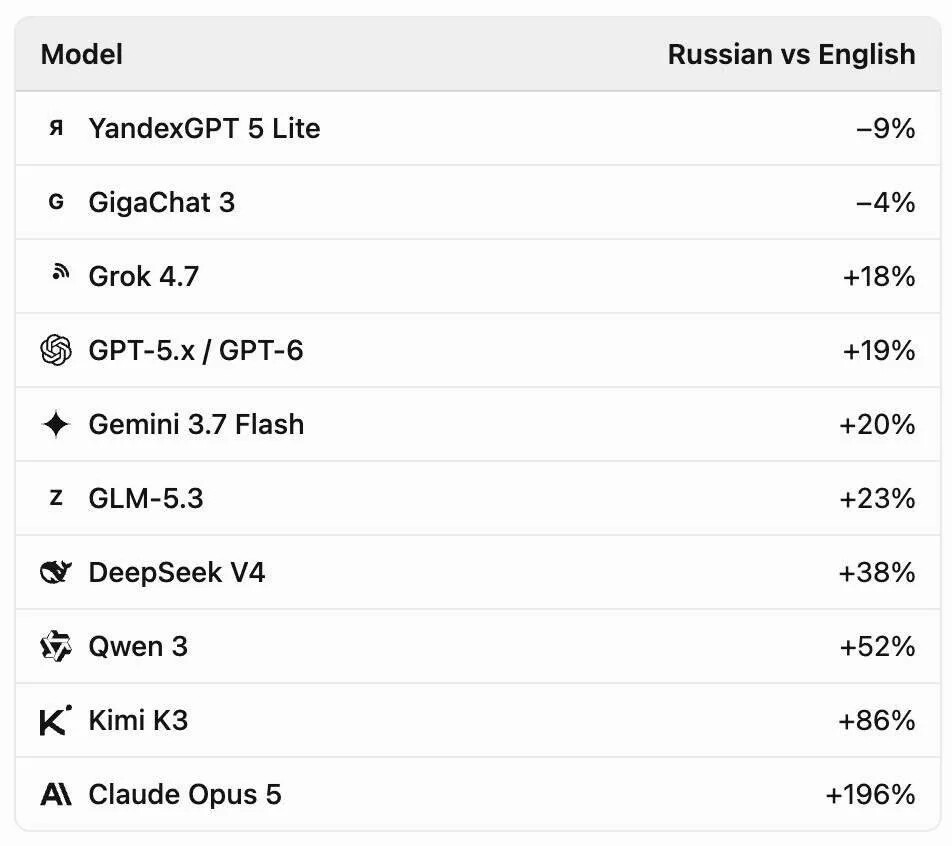
Вот такую табличку нашел. Поделитесь в комментах источником, кто знает, и скажите, правда ли это. По табличке выходит, что иностранные ИИ-модели жрут больше токенов при общении на русском, а отечественные меньше. И это несмотря на вопли о том, что "отечественные ИИ это просто старая версия условного DeepSeek/Qwen с переклеенным шильдиком и встроенными фильтрами цензуры от корпорации производителя". Получается все-таки не так или не совсем так.